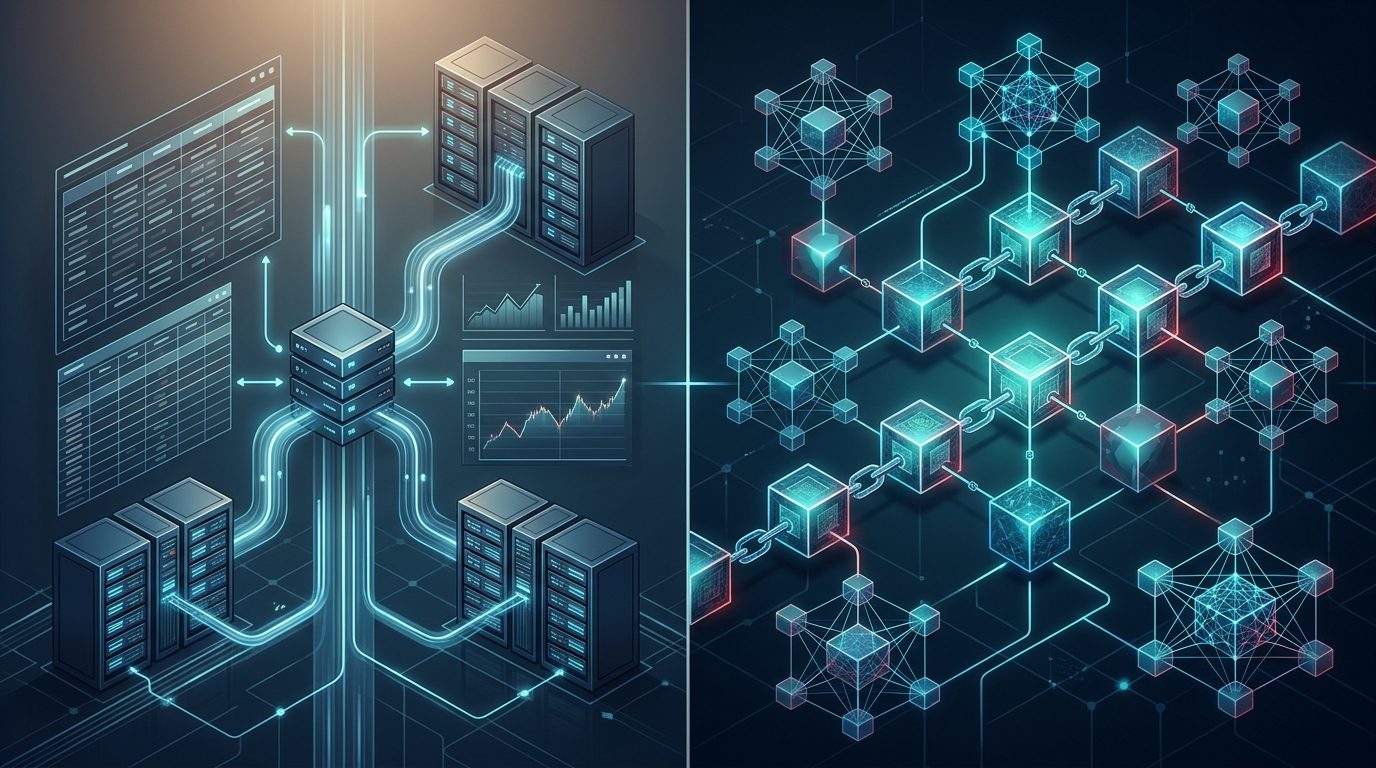
L’engouement suscité par les technologies décentralisées a parfois brouillé les frontières conceptuelles de l’ingénierie logicielle. Régulièrement, des porteurs de projets comparent la blockchain aux bases de données distribuées classiques, voire les opposent à tort. Si toute blockchain constitue, par nature, une forme particulière de registre distribué, l’inverse est loin d’être vrai. Confondre ces deux approches conduit inévitablement à des erreurs de conception, des coûts superflus ou des architectures inadaptées aux exigences de volumétrie.
Pour déterminer quel outil répond le mieux à un besoin applicatif, il convient d’analyser en profondeur les mécanismes de stockage, les paradigmes de gouvernance, les performances brutes et les modèles de confiance sous-jacents.
Architecture et gestion de l’état : le modèle CRUD face au registre append-only
Une base de données relationnelle ou NoSQL classique, même lorsqu’elle est distribuée sur plusieurs serveurs à travers le globe (comme Apache Cassandra, CockroachDB ou Google Spanner), repose historiquement sur le cycle CRUD : Create, Read, Update, Delete. Dans ce modèle, l’information peut être mise à jour ou supprimée pour refléter l’état instantané du système. Lorsqu’un solde bancaire ou un stock change, la valeur précédente est écrasée ou archivée selon des règles définies par les développeurs, afin d’optimiser l’espace disque et la rapidité de lecture.
À l’inverse, pour appréhender la technologie blockchain et son fonctionnement, il faut concevoir le système comme un journal linéaire d’événements strictement additif (append-only). Aucune écriture ne vient écraser une donnée passée. Les transactions sont regroupées chronologiquement au sein de blocs reliés entre eux par des empreintes cryptographiques (fonctions de hachage). Chaque bloc conserve la racine de Merkle de ses transactions et le hash du bloc précédent, rendant toute modification rétroactive mathématiquement détectable et caduque.
Cette différence structurelle dicte la philosophie de conservation : la base distribuée privilégie la consultation instantanée de l’état présent, tandis que la blockchain garantit l’auditabilité totale de la trajectoire historique qui a conduit à cet état.
Gouvernance, autorité et modèles de confiance
La distinction la plus profonde entre ces deux univers ne réside pas dans le matériel, mais dans les relations de confiance entre les participants du réseau.
L’autorité administrative des bases distribuées
Dans une base de données distribuée d’entreprise, un administrateur système (DBA) ou une entité centrale conserve les privilèges suprêmes (droits root). L’administrateur peut modifier le schéma des tables, altérer des enregistrements erronés, restaurer une sauvegarde antérieure ou révoquer les accès d’un nœud défaillant. La synchronisation entre les différents serveurs s’appuie sur des algorithmes comme Paxos ou Raft, conçus pour tolérer des pannes matérielles (Crash Fault Tolerance ou CFT), mais incapables de gérer des acteurs délibérément malveillants.
L’absence de tiers de confiance sur la blockchain
La blockchain a été pensée pour fonctionner dans un cadre où les participants ne se font pas confiance et peuvent même avoir des intérêts divergents. Elle introduit des mécanismes de tolérance aux pannes byzantines (BFT), tels que la preuve de travail (PoW) ou la preuve d’enjeu (PoS). Aucun nœud ne dispose de droits privilégiés pour annuler unilatéralement une transaction confirmée.
La sécurité repose en grande partie sur la cryptographie asymétrique, chaque acteur signant numériquement ses instructions à l’aide d’une clé privée. La vérité partagée n’émane pas d’un serveur maître, mais de l’application rigoureuse des règles du protocole par l’ensemble des validateurs indépendants.
Performances, débit et scalabilité : le dilemme du théorème CAP
Sur le plan des performances pures, opposer une base distribuée à une chaîne de blocs met en lumière un écart d’ordres de grandeur considérable :
- Débit de transactions : Une base de données distribuée moderne et bien dimensionnée peut ingérer facilement entre 50 000 et plusieurs millions d’opérations par seconde avec une latence de quelques millisecondes. Une blockchain publique de première ou deuxième génération traite généralement entre 15 et une centaine de transactions par seconde au niveau de sa couche de base, avec des temps de finalité s’étalant de quelques secondes à plusieurs minutes.
- Redondance et stockage : Dans une base de données, la technique du partitionnement (sharding) divise le jeu de données pour que chaque serveur n’en stocke qu’une fraction. Sur une blockchain décentralisée sans sharding d’état, chaque nœud complet archive l’intégralité du registre, ce qui limite considérablement l’efficience globale du réseau.
- Coût computationnel : Exécuter du code ou vérifier des transactions répétées par des milliers de validateurs génère un coût économique et énergétique bien supérieur à l’exécution d’une requête SQL sur un cluster d’entreprise.
Comme le souligne l’analyse des avantages de la blockchain face aux systèmes traditionnels, ce compromis est assumé : la blockchain sacrifie délibérément la rapidité d’exécution et l’optimisation des ressources pour acquérir une résistance absolue à la censure et une immuabilité sans intermédiaire.
Comment orienter son choix technologique ?
Afin d’éviter le piège récurrent de la sur-ingénierie, plusieurs critères objectifs permettent d’orienter le choix vers l’une ou l’autre de ces solutions :
- Nombre d’écrivains et degré de confiance : Si toutes les écritures sont réalisées par une organisation unique ou des filiales sous le même contrôle juridique, une base de données distribuée (PostgreSQL distribué, CockroachDB, DynamoDB) est presque toujours la réponse adaptée.
- Nécessité de supprimer des données : Si l’application doit impérativement respecter le droit à l’effacement prévu par les législations sur la protection de la vie privée (RGPD), la blockchain publique est inadaptée en couche de stockage direct.
- Besoin d’interopérabilité neutre : Lorsque plusieurs acteurs économiques concurrents doivent collaborer au sein d’une chaîne logistique ou d’un consortium sans qu’aucun d’entre eux ne prenne le contrôle de l’infrastructure, le registre blockchain s’impose naturellement.
- Volume et fréquence des flux : Pour des flux de données télémétriques, des catalogues de produits ou des analyses Big Data, la base distribuée reste l’outil incontournable.
« Utiliser une blockchain publique lorsque la confiance est déjà institutionnellement assurée revient à payer le prix de la décentralisation sans en récolter les bénéfices réels. »
Vers des architectures hybrides et pragmatiques
Le monde de l’entreprise s’éloigne aujourd’hui des visions dogmatiques. La tendance dominante privilégie des approches mixtes, où les deux technologies opèrent en synergie. Les volumétries lourdes et les données sensibles continuent de résider dans des bases de données réparties classiques, tandis que des ancrages cryptographiques réguliers sont enregistrés sur la blockchain pour figer l’état du système et fournir des preuves d’intégrité infalsifiables.
Dans de nombreuses filières, explorer le potentiel des blockchains hybrides permet de concilier la confidentialité des accès internes avec la certification externe offerte par les registres publics. La question n’est donc plus de savoir si la blockchain supplantera les bases de données, mais comment ces outils complémentaires peuvent s’agencer pour conjuguer performance de calcul et résilience de la confiance.